
Bonjour,
Un travail interessant
https://news-mit-edu.translate.goog/..._x_tr_pto=wapp
https://www.nature.com/articles/s41467-026-75667-5
-----

Bonjour,
Un travail interessant
https://news-mit-edu.translate.goog/..._x_tr_pto=wapp
https://www.nature.com/articles/s41467-026-75667-5
La bêtise humaine c'est comme la corrida : c'est une tradition locale ininterrompue.
Je n'ai pas bien compris : si on supprime tous les tableaux de Van Gogh de la base d'entrainement, l'IA générative peut toujours sortir des images "à la" Van Gogh ? Gros doute.
Oui c'est bien cela et cela rebat les cartes pour la polémique sur les droits d'auteurs
La bêtise humaine c'est comme la corrida : c'est une tradition locale ininterrompue.
Sauf que la preuve rigoureuse que mon exemple est vrai ou seulement plausible n'a pas été apportée : le coût de réentrainer une IA comme Mid Journey en enlevant toutes les références à Vincent Van Gogh (puis Egon Schiele, puis Edward Hopper, puis Keith Haring etc... pour être sûr de son coup avec d'autres artistes singuliers reconnaissables) est prohibitif, largement inaccessible pour une université. Les chercheurs ont donc été contraints de "tricher", et risquent de se rendre coupables d'extrapolation quant aux résultats sur des IA grandeur nature. Je n'ai pas encore lu l'article (je vais le faire), mais le ver est sûrement dans la méthodologie.
Le principe de Sagan s'applique ici : « des affirmations extraordinaires nécessitent des preuves extraordinaires ».
Note que ce n'est pas le problème du droit d'auteur qui m'intéresse ici (et que l'on devrait discuter), mais la vérité prétenduement scientifique de certaines affirmations.
Dernière modification par GBo ; 05/09/2026 à 06h22.
Ils ont trouvés une méthode !
La bêtise humaine c'est comme la corrida : c'est une tradition locale ininterrompue.
quand on entraine une IA sur un grand ensemble d'oeuvres (peintures, musiques, livres etc ..) est ce qu'on lui donne l'information sur l'auteur? je suppose que oui sinon on ne pourrait pas lui demander de générer des oeuvres " à la manière de"; Mais dans ce cas les oeuvres générées explicitement "à la manière de" sont forcément influencées par et attribuables aux oeuvres originales...
Merci de ton éclairage expert que tu devrais partager avec les chercheurs du MIT qui semblent ne pas bien avoir compris comment cela fonctionne.Envoyé par Cyrano

La bêtise humaine c'est comme la corrida : c'est une tradition locale ininterrompue.
en quoi ce que j'ai dit est contradictoire avec le travail des chercheurs du MIT ?
C'est justement ce qu'ils ont développés : "l'attribution decay"
"Les scientifiques ont identifié un phénomène qu'ils appellent la dégradation de l'attribution : plus un modèle génératif est entraîné sur un grand nombre de données, moins chaque exemple d'entraînement a d'importance pour un résultat particulier. Cela peut paraître contre-intuitif, mais à grande échelle, ils constatent qu'on peut souvent supprimer une image des données d'entraînement, ou toutes les images d'un artiste donné, ou encore toutes les photographies d'une personne donnée, sans que l'échantillon généré ne soit modifié."
La bêtise humaine c'est comme la corrida : c'est une tradition locale ininterrompue.
Citation de l'article.ils constatent qu'on peut souvent supprimer une image des données d'entraînement, ou toutes les images d'un artiste donné, ou encore toutes les photographies d'une personne donnée, sans que l'échantillon généré ne soit modifié.
Je n'ai pas lu celui de Nature, mais j'ai une question ; comment peuvent-ils être absolument certains qu'il ne reste aucune trace des données qu'ils ont supprimées?
Peuvent-ils en apporter la preuve?
Un peu plus loin ;Mais apparemment c'est beaucoup trop cher...Y répondre honnêtement impliquait de réentraîner le modèle à partir de zéro sans cette image, puis de répéter l’opération pour chaque image
La suite :Pour ce que j'ai souligné en gras : ils entendent quoi par là?Leur solution de contournement repose sur une architecture qu'ils ont eux-mêmes conçue, appelée « ensemble de diffusion ». Au lieu d'un modèle monolithique, elle est composée de nombreux composants plus petits, chacun entraîné sur une portion différente des données. Vous voulez savoir comment le modèle se comporterait sans une image particulière ? Il suffit de désactiver les parties qui l'ont utilisée. Aucun réentraînement, aucune approximation. On obtient ainsi un véritable modèle contrefactuel, et non une simple estimation.
"Музыки хватает на всю жизнь, но целой жизни не хватает для музыки"
Rachmaninoff
La soustraction des oeuvres de la base est totale. Cela veut dire que l'IA n'as jamais vu un VAN GOGH mais peu faire du VAN GOGH quand même
La bêtise humaine c'est comme la corrida : c'est une tradition locale ininterrompue.
le t de mon clavier est fainéant ce matin et le s trop actif
La bêtise humaine c'est comme la corrida : c'est une tradition locale ininterrompue.
Comment peuvent-ils être absolument certains qu'il ne reste aucune trace?
"Музыки хватает на всю жизнь, но целой жизни не хватает для музыки"
Rachmaninoff
La méthode est complexe, perso je me contente de la vulgarisation mais vu les enjeux cette méthode risque d'être vue et revue sous toutes les coutures par pas mal d'équipes.
https://www.nature.com/articles/s414...67-5/figures/2
La bêtise humaine c'est comme la corrida : c'est une tradition locale ininterrompue.
Voilà. C'est ça qui est important.
"Музыки хватает на всю жизнь, но целой жизни не хватает для музыки"
Rachmaninoff
En même temps le MIT c'est loin d'être des charlots..
La bêtise humaine c'est comme la corrida : c'est une tradition locale ininterrompue.
dans ce cas comment pourrait-il générer une oeuvre dans le style d'un auteur si il a oublié de qui venaient les oeuvres ? qu'on ne puisse pas attribuer la création à UN exemple particulier c'est une chose, qu'il ne garde pas la mémoire collective de l'ensemble de l'oeuvre en est une autre. Ca me parait contradictoire de dire qu'il a oublié d'où venaient les oeuvres et en même temps qu'il puisse les reproduire.
Je ne vois pas comment on pourrait entrainer sur des peintures en excluant celles de Picasso puis ensuite qu'il soit capable de reproduire des oeuvres dans le style de Picasso, ça parait totalement absurde puisqu'il ne peut pas savoir qui était Picasso.
Certes mais il se peut que des charlots lisent leurs articles et les comprennent de travers ....
Dernière modification par Cyrano ; 05/09/2026 à 09h56.
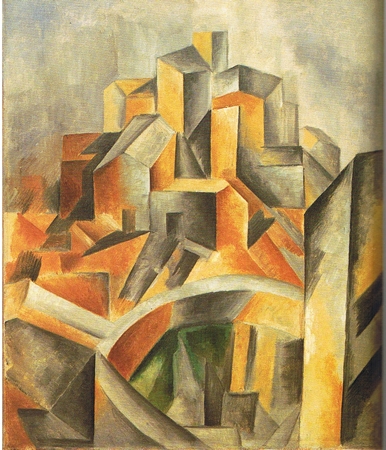
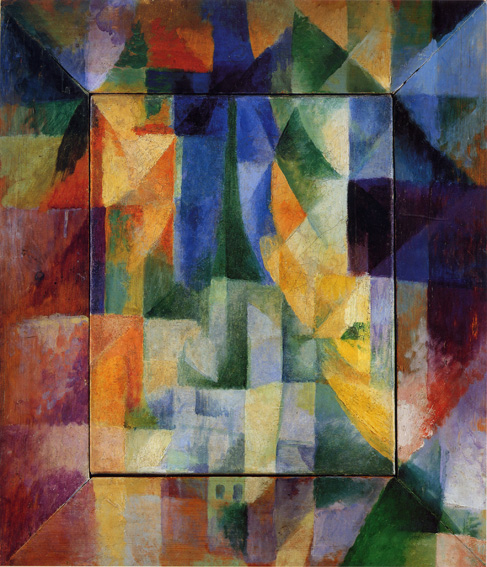
Picasso n'est pas forcément un bon exemple car dans le mouvement cubiste il y aussi George Braque, Fernand Léger, les Delaunay etc..., c'est pour ça que je prenais l'exemple de peintres au style caractéristique qui (à ma connaissance d'amateur d'art) n'ont pas été suivis depuis.
Picasso:
Dernière modification par GBo ; 05/09/2026 à 10h37.
Robert Delaunay :
L'article ne dit pas que si une IA n'a jamais vu de Rembrandt, elle va faire du Rembrandt quand même.
Ce qu'elle dit est plus limité mais précis : on entraine sur un jeu de données, on donne un prompt comme "Face of a woman, gray hair, wearing necklace" puis on cherche dans les données d'entrainement ce qui est le plus proche.
C'est l'attribution. On efface les images les plus proches, on réentraine et on obtient le même résultat.
Conclusion : l'attribution telle qu'on la pratique actuellement, sujet important pour les droits d'auteur et autres n'est pas forcément pertinente.
C'est tout et il va falloir attendre d'autres travaux, les retours sur celui là, etc pour en savoir plus.
Sinon, deux choses :
- pour ceux qui jugent très vite, l'article sur Nature est en accès libre et donne les liens vers le repo GitHub qui permet de reproduire le travail. Je suggère donc de s'y attaquer pour le démonter parce que ce sera plus intéressant que 1 ou 2 phrases définitives ici.
- pour ce qui est de Rembrandt, on peut parfaitement imaginer qu'une IA qui n'aurait jamais vu de tableau de lui mais ce qui est venu avant et après et lu des livres d'histoire de l'art avec description soit capable d'en générer un ressemblant.
C'est un peu le thème de l'article du MIT : quand a appris sur beaucoup de données, on ne peut pas tracer une influence précise. Bref, la culture, c'est ce qui reste quand on a tout oublié.
Salut pm42, comment tu comprends cette phrase (qui m'interpelle) dans le texte final de l'article :
"We emphasize that our study focuses on leave-one-out style attribution, where the goal is to find a single unit of training data to which to attribute a generated sample. This differs from aggregate, subset-level, or approximate attribution methods, which are valuable formany applications.Ourmainfindings do not preclude the ability to perform these other kinds of attributions, however they do show that further refinement along these lines will likely not yield methods that can perform attribution on the level of individual images, people, or artists."
Source: https://www.nature.com/articles/s41467-026-75667-5.pdf
Qui fait suite à un remarque d'un reviewer:
... auquel l'auteur principal a répondu par:# Weakness
1. Interpretation of “Unattributability”
The manuscript occasionally risks being interpreted as claiming that no meaningful attribution is possible under any circumstances. It would be helpful to more explicitly distinguish causal leave-one-out attribution at the level of individual units (the focus here), from aggregate, subsetlevel, or approximate attribution methods that may still be useful in practice. Clarifying this distinction in the Discussion would reduce the risk of overgeneralization.
"We have expanded the discussion (lines 254-260) to more explicitly state that our findings apply specifically to unit level leave-one-out attribution, and that this differs from aggregate, subsetlevel, or approximate attribution methods. We also note that although our findings do not preclude the ability to perform these other kinds of practically useful attributions, further refinement along these lines will likely not yield methods that can perform unit level leave-oneout attributions, the implications of which we discuss throughout the remainder of the section."
Source: https://media.springernature.com/ori...MOESM2_ESM.pdf
Dernière modification par GBo ; 05/09/2026 à 11h45.
Comme en gros ce que j'ai expliqué : ils ont montré d'après eux qu'un certain type d'attribution, à quelques données précises n'était pas pertinente.
La critique dit qu'il faut faire attention, que leur travail pourrait être interprété comme l'impossibilité de toute attribution, ce qui d'une certaine façon a été faite dans ce fil en effet et leur réponse est qu'en effet, ce n'est pas du tout leur discours.
P.S : je suis un peu pressé donc j'ai lu et répondu vite.
En clair, sous réserve de ma bonne compréhension, le passage ci-dessus de l'article scientifique semble beaucoup plus modeste dans son impact que la "claim" (que j'ai mise en gras ci-dessous) de l'article du MIT :
"The scientists identified a phenomenon they call attribution decay, where the more data a generative model is trained on, the less any individual training example matters to any particular output. It feels counterintuitive, but at sufficiently large scales, they find, you can often remove any single image from the training data, or every image by a given artist, or every photograph of a given person, and the generated sample doesn't change."
Bref, je ne trouve pas dans l'article de Nature où est l'équivalent d'avoir supprimé toutes les images de tableaux Rembrandt dans les données d'apprentissage, mais je veux bien qu'on me le pointe du doigt sinon.
Dernière modification par GBo ; 05/09/2026 à 12h02.
Cela amène toujours à une question de définition et de limites.
https://fr.wikipedia.org/wiki/International_Klein_Blue
Autre question : pourquoi pas un prompt pour une IA écrit de telle sorte que celui-ci génère une sortie qui soit suffisamment ressemblante à une œuvre sous copyright pour être illégale et ce malgré le fait que l'IA n'ait pas été entraînée sur les données copyrightées en question ?
La bêtise humaine c'est comme la corrida : c'est une tradition locale ininterrompue.
Oui mais c'est fréquent : l'article grand public est là pour faire du buzz.
J'ai fait l'effort de lire l'article réel sur Nature mais sinon le faire lire par une IA et lui demander une vulgarisation donnera sans doute quelque chose de plus réaliste.
On peut aussi demander une comparaison entre les deux textes.
Rapidos avec Gemini :
Dimension Article de Nature (La réalité scientifique) Article du MIT (Le prisme médiatique) Portée de l'étude Démontre un phénomène d'atténuation de l'attribution (attribution decay) : l'influence d'un échantillon individuel tend vers zéro à très grande échelle dans certaines conditions de diffusion. Traduit cela par : « L'IA génère de l'art qui n'a plus d'auteur et se détache de ses sources ». Nuance technique Valable pour les modèles de diffusion testés et sous des métriques d'ablation précises. Généralisé à « l'art de l'IA » en général, créant une vision binaire (traçable vs complètement autonome). Objectif Informer la communauté scientifique de l'inefficacité des méthodes d'attribution traditionnelles face à la taille des datasets. Influencer le débat public, alimenter la chronique tech et nourrir les discussions sur la régulation de l'IA.
La bêtise humaine c'est comme la corrida : c'est une tradition locale ininterrompue.
Question ; est-ce qu'il existe pour les articles publiés dans le cadre des sciences informatiques et du numérique, l'équivalent d'une échelle de niveaux de preuves ( évidemment adaptée aux sujets et aux caractéristiques des sciences informatiques) comme celle qui existe pour les articles scientifiques en médecine?
Pour rappel, l'échelle des niveaux de preuves c’est ça ; https://www.echosciences-grenoble.fr...des-a-la-loupe
"Музыки хватает на всю жизнь, но целой жизни не хватает для музыки"
Rachmaninoff
Je suis un peu interloqué aussi. Une IA générative ne conserve pas en mémoire les œuvres d'art avec lesquelles on l'a entrainé mais a affecté des pondérations à chaque neurone artificiel au cours de l'apprentissage.
Comment à partir de là peut-on "supprimer" l'apprentissage ?
Si quelqu'un comprend qu'il m'explique: l'IA générative ne travaille pas avec des bases de données ce me semble et qui seraient stockées de façon permanente sur un disque ou un support
Donc comment peut-on supprimer l'apprentissage de façon permanente ?
Intéressant mais à ma connaissance non parce qu'il y a :
- l'informatique théorique qui est des maths : donc la preuve, c'est du niveau démonstration, vrai ou faux, pas d'échelle
- des heuristiques : par exemple, on a des cas où on ne sait trouver la solution optimale à un problème mais on a différentes techniques qui marchent bien
- coté ingénierie, des résultats expérimentaux qui peuvent varier dans le temps : par exemple, on a des métriques sur combien de serveurs, mémoire, réseau il faut pour faire tourner un site de e-commerce qui reçoit X milliers (ou plus) de visites par jour.
P.S : par acquis de conscience, j'ai copié-collé ta question dans Claude pour vérifier si j'avais raté quelque chose et sa réponse est très proche de la mienne.
P.P.S : ceci dit, l'IA change la façon dont on évalue et même si on n'en est pas encore là, c'est plus proche de la grille que tu as donné donc il est possible que la convergence s'accentue dans le futur.
j'ai l'impression (mais j'ai peut etre mal compris) que les auteurs cherchent à disculper les IA de l'accusation de plagiat d'une oeuvre spécifique en montrant que l'influence d'UNE oeuvre peut devenir très petite si l'ensemble utilisé devient grand (ce qui est assez logique car plus l'ensemble est grand plus le poids est faible). Cependant ca n'exclut pas qu'il y ait un poids significatif de l'ensemble des oeuvres d'un artiste dans l'apprentissage, donc ça laisse ouvert la question du droit d'auteur meme si on ne peut pas prouver que c'est une oeuvre particulière qui a été copiée.
A mon avis derrière ces études il y a de gros enjeux judiciaires et financiers, il n'est pas impossible que des compagnies développant des IA cherchent à protéger leur business en finançant des recherches tendant à attenuer leur responsabiité. De la même façon par exemple que le développement des voitures autonomes posent des redoutables problèmes de responsabilités en cas d'accident (ce qui interesse en premier chef les compagnies d'assurance).
